
데이터의 이해와 데이터 분석 강의를 듣고 나서 바로 pandas 실습에 들어갔다.
원래는 공공데이터포털에서 공공데이터를 받아 CSV 를 읽고 데이터프레임을 보는 식으로 배운다는데, 우리는 Series 가 뭔지 DataFrame 이 뭔지부터 배우고 실습하기로 했다.
Table of contents
Open Table of contents
프로젝트 세팅
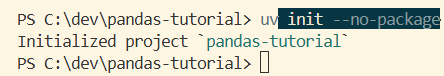
uv 로 시작했다.
uv init --no-package--no-package 를 붙이면 pyproject.toml 에서 패키지 설정이 빠진 채로 init 된다.
여기에 필요한 라이브러리를 넣었다.
uv add pandas numpy ipykernel이 명령을 실행하면 .venv 폴더가 생기고 Lib 폴더 안에 해당 라이브러리가 설치된다.
그다음 install_check.ipynb 를 만들어 import 가 되는지로 설치를 확인했다.
import pandas as pd
import numpy as np
주피터 노트북이 가상환경 커널을 못 잡는 경우 — 파이썬 인터프리터 경로를 직접 지정해주면 된다.
.venv/Scripts/python.exe를 지정했다.
pandas 는 무엇을 하는 라이브러리인가
정형 데이터가 파일로 있을 때, 그걸 파이썬 안에서 이해할 수 있는 형태로 바꿔주고 계산까지 해주는 라이브러리다.
정형 데이터는 주로 표 형태다. 표는 2차원 배열이고, pandas 는 이 표를 파이썬 객체로 바꿔준다. 그 객체가 DataFrame 이다.
그리고 Series 는 그 표를 이루는 구성요소 하나다. Series 가 여러 개 모이면 표가 되고 DataFrame 이 된다.

그래서 Series 를 다룰 줄 알면 열의 특성을 뽑거나 필요한 열만 골라내는 작업을 할 수 있다.
Series — 인덱스가 붙은 1차원 배열
Series 는 인덱스가 붙어 있는 1차원 배열 데이터다.
파이썬 리스트와 비교하면 이해가 빨랐다. 둘 다 배열이고 둘 다 인덱스가 있다. 차이는 리스트는 인덱스가 이미 정해져 있고, Series 는 인덱스를 우리가 지정할 수 있다는 것이다.
스프레드시트로 치면 열(Column) 하나에 해당한다.
만들어보면 이렇다.
pd.Series([72, 85, 90, 62])0 72
1 85
2 90
3 62
dtype: int64가로로 적었는데 세로로 출력된다. 인덱스가 자동으로 붙고, 데이터 타입도 같이 나온다. 이게 Series 의 가장 기초적인 모습이다.
Series 는 파이썬 리스트가 아니지만 리스트처럼 다룰 수 있는 게 많다.
| 확인하고 싶은 것 | 방법 |
|---|---|
| 길이 | len() |
| 차원 | ndim |
| 행렬 모양 | shape |
| 인덱스 객체 | index (RangeIndex 같은 게 나온다) |
값을 꺼낼 때도 객체니까 getter 를 써야 할 것 같았는데, 놀랍게도 scores[0] 처럼 리스트 꺼내듯 꺼내진다.
인덱스는 우리가 정한다
scores = pd.Series(
    [85, 90, 75],
    index=['student_a', 'student_b', 'student_c']
)
student_a 85
student_b 90
student_c 75
dtype: int64인덱스는 제목이 아니라 식별자다
여기서 헷갈리기 쉬운 게 나왔다. 인덱스는 값을 식별하기 위한 값이지 열의 제목이 아니다. 열의 이름은 name 인자로 따로 정한다.
s = pd.Series(
    [3.2, 5.1, 10.0],
    index=['1월', '2월', '3월'],
    name='평균기온'
)
그리고 인덱스는 중복될 수 있다.
sales = pd.Series(
    [100, 120, 150],
    index=['서울', '서울', '부산']
)sales.index.is_uniqueFalseis_unique 는 인덱스에 중복이 있는지 확인하는 것이다. 위 예제에는 서울 이 두 개라 False 가 나온다.
중복이 허용되는 이유는, 인덱스가 같아도 위치를 지정해서 가져올 수 있고 같은 인덱스인 것들을 한꺼번에 가져올 수도 있기 때문이다.
sales['서울']서울 100
서울 120
dtype: int64하나만 꺼내지는 게 아니라 Series 로 반환된다.
dtype — 섞이면 무슨 일이 생기나
Series 안에 다른 데이터 타입이 섞이면 어떻게 될까.
- 정수 + 실수 →
dtype이float64가 된다 - 자료형이 여러 개 섞임 →
dtype이object가 된다
object 가 문제인 건, 산술 연산이 안 된다는 점이다. Series 끼리 곱하는 것 같은 게 막힌다.
타입을 정하고 싶으면 만들 때 dtype 인자로 지정하거나, 만든 뒤에 astype() 으로 바꾸면 된다.
왜 굳이 Series 로 바꾸나
배열을 굳이 Series 로까지 바꾸는 이유가 궁금했는데, 답은 연산이 쉬워진다는 것이었다. 내부적으로 numpy 배열을 쓰기 때문이다.
비교 연산자를 그냥 넣으면 bool 을 내놓고, 그걸로 필터링과 마스킹이 된다.
s[s > 15]s > 15 가 True 인 것만 나온다.
인덱스를 맞춰서 더한다 — 오늘 제일 놀란 부분
Series 끼리 더할 때 pandas 는 같은 인덱스끼리 더한다. 순서가 아니라 인덱스다.
a = pd.Series([1, 2, 3], index=['x', 'y', 'z'])
b = pd.Series([10, 20, 30], index=['z', 'y', 'x'])

a + b
x 31
y 22
z 13
dtype: int64b 의 순서가 뒤집혀 있는데도 x 는 1 + 30 = 31 이 됐다. 위치가 아니라 이름표를 보고 짝을 맞춘 것이다.
그러면 한쪽에만 있는 인덱스는 어떻게 될까.
c = pd.Series([1, 2], index=['x', 'y'])
d = pd.Series([10, 20], index=['y', 'z'])

c + d
x NaN
y 12.0
z NaN
dtype: float64처음엔 왜 NaN 이 나오는지 몰랐다. 1 + 0 이 될 줄 알았는데 아니었다.
짝이 없는 쪽을 0 이 아니라 결측치로 처리하기 때문이다. 1 + 0 이 아니라 1 + NaN 으로 받아들인 것이다.
| 인덱스 | c | d | c + d |
|---|---|---|---|
| x | 1 | 없음 | NaN |
| y | 2 | 10 | 12.0 |
| z | 없음 | 20 | NaN |
생각해보면 이쪽이 맞다. 값이 없는 것과 값이 0 인 것은 다르다. 강의에서 “0 은 측정된 값일 확률이 높으니 일괄 변환하지 말라” 고 배운 것과 같은 이야기다.
그리고 결과에 NaN 이 하나라도 있으니 정상적으로 더해진 y 까지 12.0 으로, 정수가 실수로 바뀌었다.
Series 를 만드는 여러 방법
두 번째 인자를 인덱스로 — 키워드 없이 그냥 넣어도 된다.
values = [1200, 1500, 1700]
fruits = ['사과', '바나나', '딸기']

pd.Series(values, fruits)
values 는 값으로, fruits 는 인덱스로 처리된다.
딕셔너리로도 만들 수 있다. 이건 좀 신기했다.
student = {
    "수학": 90,
    "과학": 90,
    "영어": 20
}

pd.Series(student)
JSON 을 딕셔너리로 바꾸는 것도 되는데, 바로 Series 에 넣을 수는 없고 평탄화 작업이 필요할 수도 있다고 한다. (아직 직접 해보진 않았다.)
딕셔너리 + index 를 같이 주면 골라낸다.
data = {
    '서울': 10,
    '부산': 20,
    '대전': 301,
    '천안': 235
}

labeled_data = pd.Series(data, index=['서울', '부산'])
index 로 지정한 서울과 부산만 나온다.
여기서 한 번 더 확인한 게 있다. data 에 없는 '대구' 를 index 에 넣으면 에러가 나지 않는다. 대구 행은 나오되 값이 NaN 으로 채워진다.
앞의 덧셈과 같은 규칙이다. pandas 는 인덱스를 기준으로 맞추고, 짝이 없으면 NaN 을 넣는다.
더 공부해볼 것
- 튜플과 배열의 차이 — 실습 중에 떠오른 의문이다. 파이썬의 튜플 · 리스트 · numpy 배열 · pandas Series 가 각각 뭐가 다른지 한 번에 정리해볼 것
[]와.loc와.iloc—scores[0]이 그냥 되길래 위치로 꺼낸 줄 알았는데, 인덱스를 직접 지정한 Series 에서도 같은 방식이 통할지 확인이 필요하다. 라벨로 찾는 것과 위치로 찾는 것이 다른 동작이라면 언제 어느 쪽이 쓰이는지 (pandas indexing 문서)NaN대신 0 으로 채우고 싶을 때 — 이번엔NaN이 나오는 게 맞는 동작이었지만, 의도적으로 0 으로 채우려면 어떻게 하는지.add()에fill_value같은 게 있는지 확인해볼 것objectdtype 이 왜 연산을 막는가 — 자료형이 섞이면object가 되고 산술 연산이 안 된다고 배웠는데, 내부적으로 무엇이 달라지는지. numpy 배열의 dtype 과 연결해서 볼 것NaN이 있으면 왜 정수가 실수가 되는가 —int64에는 결측을 표현할 자리가 없어서인 것 같은데 확인이 필요하다. pandas 에Int64(대문자) 같은 nullable 정수 타입이 따로 있다고 들었다- 인덱스 중복을 실무에서 어떻게 다루는가 — 중복이 허용된다는 건 알겠는데, 실제로 중복 인덱스를 그대로 두고 쓰는 경우가 있는지 아니면 대개 정리하고 시작하는지