
Series 에 이어 DataFrame 을 봤다.
Table of contents
Open Table of contents
표를 파이썬으로 만들기
먼저 마크다운으로 표를 하나 만들어봤다.
|메뉴|가격|판매량|
|---|---|---|
|아메리카노|4500|152|
|카페라떼|5000|98|
|바닐라라떼|5500|67|
|카푸치노|5000|45|
이 표를 파이썬 기본 문법만으로 만들 수 있을까. 딕셔너리를 쓰면 된다.
data = {
    "메뉴": ["아메리카노", "카페라떼", "바닐라라떼", "카푸치노"],
    "가격": [4500, 5000, 5500, 5000],
    "판매량": [152, 98, 67, 45]
}
정형 데이터를 파이썬으로 나름대로 풀어낸 것이다. 이걸 그대로 DataFrame 에 넣으면 표가 나온다.
df = pd.DataFrame(data)
df
메뉴 가격 판매량
0 아메리카노 4500 152
1 카페라떼 5000 98
2 바닐라라떼 5500 67
3 카푸치노 5000 45DataFrame 은 결국 열이 합쳐진 것이다. 메뉴 열 + 가격 열 + 판매량 열. 그래서 Series 를 먼저 배웠던 것이다.
Series 는 1차원이고 DataFrame 은 2차원이다. Series 에서 봤던 ndim 으로 확인할 수 있다.
행 꺼내기, 열 꺼내기
DataFrame 은 열이 여러 개 붙어 있는 것이라, 레코드 하나를 가져오려면 각 열에 있는 정보를 다 가져와야 한다.
행은 loc · iloc 로 꺼낸다. Series 에서 쓰던 것과 같다.
delivers.loc[0]이렇게 꺼내면 object Series 로 반환된다. 행 단위로 꺼내면 열마다 자료형이 다르니 웬만해선 object 가 된다. 그래서 필요한 것만 꺼내오는 게 중요할 것 같다.
열은 대괄호에 이름을 넣는다.
delivers["delivered"]loc 와 달리 열 정보를 Series 로 가져온다.
행렬 위치로 값 하나를 꺼낼 때는 iloc 에 두 개를 넣는다.
df.iloc[2, 0]모양부터 본다
DataFrame 에서 가장 중요한 건 모양이다.
delivers.shape(3, 4)행, 열 순서로 튜플이 나온다. 3행 4열이면 속성 4개를 가진 기록 3개라는 뜻이다.
인덱스는 두 종류가 있다. DataFrame 자체의 인덱스는 행 번호를 말하고, 열 이름도 인덱스가 될 수 있다.
df.index     # RangeIndex
df.columns   # 열 이름
RangeIndex 대신 각각의 인덱스를 붙이고 싶으면 Series 때와 똑같이 주면 된다.
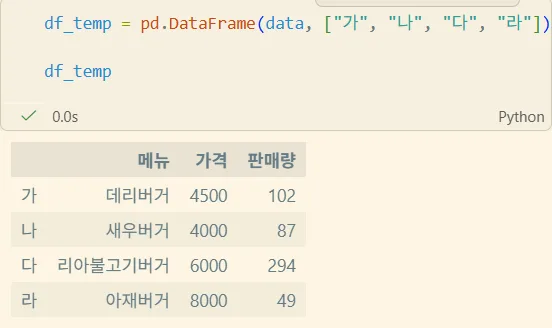
Series 를 여러 개 만들어서 DataFrame 으로 합칠 때는 배열이 아니라 딕셔너리로 넣는다. 각 Series 가 어느 열에 속하는지 딕셔너리로 표현해서 넣는 게 일반적이다.
데이터 분석만 한다면 DataFrame 을 직접 만들 일은 없다. 원본에서 Series 를 뽑아 새 DataFrame 을 만들어야 할 때 이렇게 한다는 정도만 알면 될 것 같다.
파생 변수
열을 뽑아 연산하면 파생 변수를 만들 수 있다.
df['quantity'] * df['unit_price']0 1350000
1 560000
2 150000
dtype: int64Series 끼리 곱했고 결과도 Series 다.
이걸 기존 DataFrame 에 붙이려면 새 열 이름을 지정하고 값을 넣으면 된다.
df['total'] = df['quantity'] * df['unit_price']Series 로 뽑을 때와 DataFrame 으로 뽑을 때
열 여러 개를 고르는 방법은 Series 때와 같다. Series 에서는 인덱스를 배열로 줬는데, DataFrame 에서는 열 이름을 배열로 준다.
df[['quantity', 'unit_price']] quantity unit_price
0 1 1350000
1 2 280000
2 3 50000여기서 걸리는 게 있었다. 한 개만 골라도 배열로 감싸면 DataFrame 이 나오고, 감싸지 않으면 Series 가 나온다.
| 표기 | 결과 |
|---|---|
df['quantity'] | Series |
df[['quantity']] | DataFrame |
Series 로 뽑을 때는 요소로 뽑아오고 DataFrame 으로 뽑을 때는 배열로 뽑아온다. 그래서 쓰는 자리가 갈린다. 열 하나를 계산 · 비교 · 필터 조건으로 쓸 거면 Series 로, 표 구조를 유지해야 하면 DataFrame 으로 뽑는다.
자료형은 테이블이 아니라 열에 있다
테이블에는 자료형이 없다. 열에 있다. 그래서 테이블 안에 어떤 자료형이 들어 있는지 한눈에 보기 어렵고, 열별로 조회하는 방법이 따로 필요하다.
df.dtypesproduct str
quantity int64
unit_price int64
dtype: object맨 아래 dtype: object 는 dtypes 가 돌려준 Series 자체의 자료형이고, 그 위가 각 열의 자료형이다. product 는 str, quantity 와 unit_price 는 int64 다.
info() 부터 본다
df.info()<class 'pandas.DataFrame'>
RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 product 3 non-null str
1 quantity 3 non-null int64
2 unit_price 3 non-null int64
dtypes: int64(2), str(1)
memory usage: 204.0 bytes인덱스, 열 정보, 결측 여부, 자료형, 메모리 사용량까지 한 번에 정리해준다.
이건 분석을 위한 정보는 아니다. 하지만 이걸 알아야 분석을 할 수 있다. 그래서 DataFrame 을 받으면 df.info() 부터 해본다. 내가 분석하려는 표가 어떻게 생겼는지부터 보는 것이다.
실제로 빈 값을 넣고 info() 를 해보니 Non-Null Count 에 그대로 반영됐다. 이때 줄어드는 건 non-null 숫자뿐이라, 전체 엔트리가 몇 개인지를 정확히 봐야 한다. 엔트리 수를 모르면 non-null 이 줄어든 걸 알아챌 수가 없다.
정수만 있어야 하는 열이
float으로 보이면NaN이 있구나 하고 짐작할 수 있다.
전치
df.T 를 쓰면 행과 열의 위치가 바뀐다.
탐색
| 함수 | 하는 일 |
|---|---|
df.head() | 앞에서 5개 |
df.tail() | 뒤에서 5개 |
df.sample() | 임의로 뽑기 (기본 1개) |
df.describe() | 기술통계량 |
df.nunique() | 열별 고유값 개수 |
sample() 은 부를 때마다 다른 게 나온다. 무작위 값을 고정하려면 random_state 에 시드를 준다.
orders.sample(2, random_state=42)몇 번을 다시 실행해도 같은 결과가 나온다. 다른 컴퓨터에서도 마찬가지다. 코랩에서 확인해보니 시드가 같으면 같은 값이 나왔다.
개수가 아니라 비율로 뽑을 수도 있다.
orders.sample(frac=0.25)describe()
describe() 를 하면 개수 · 평균 · 최솟값 · 최댓값 · Q1 · Q3 · 중앙값 · 표준편차가 나온다. std 가 표준편차다. count 는 결측값을 제외한 개수다. 날짜 데이터에도 기술통계량이 나온다.
원하는 열만 보려면 열을 고른 결과에 describe() 를 붙이면 된다.
orders[
    ['quantity', 'unit_price', 'discount_rate']
].describe()
str 열은 자동으로 빠지는 것 같다.
nunique()
orders.nunique()order_date 10
customer 5
region 3
product 3
quantity 5
unit_price 3
discount_rate 3
paid 2
dtype: int64범주형 데이터에서 많이 쓴다. 범주형이 진짜 범주형이 맞는지 확인하거나, 데이터 오염이 있는지 보거나, 인코딩 방식을 정할 때 쓴다.
#1 에서 배운 인코딩과 이어진다. 명목형이면 원-핫, 순서형이면 서열 인코딩을 쓰는데, 고유값이 몇 개인지 모르면 원-핫으로 열이 몇 개까지 늘어날지 가늠할 수가 없다.
더 공부해볼 것
describe()가str열을 빼는 규칙 — 자동으로 빠지는 것 같은데 확인이 필요하다. 문자열 열의 기술통계량을 보고 싶을 때 방법이 따로 있는지도 (pandasdescribe)- 날짜 데이터의 기술통계량 — 날짜에도 나온다고 하는데 평균 날짜나 표준편차가 무엇을 뜻하는지
- Q1 · Q3 로 이상치 잡기 — #1 에서 이상치를 어디서 자를지 숙제로 남겼는데
describe()에 Q1 과 Q3 가 이미 나온다. IQR 로 경계를 정하는 방법을 여기에 이어 붙일 것 - 파생 변수를 붙일 때 주의할 것 —
df['total'] = ...로 붙는 건 확인했는데, 원본 DataFrame 을 슬라이싱한 것에 붙이면 경고가 뜬다고 들었다. 언제 사본이 되고 언제 원본이 되는지 memory usage를 언제 신경 쓰나 —info()에 나오지만 지금 데이터는 작아서 감이 없다. 어느 규모부터 자료형을 바꿔서 줄이는 작업이 필요해지는지sample()의n과frac— 개수로 뽑는 것과 비율로 뽑는 것을 실제로 어떤 상황에서 나눠 쓰는지