
Iris 데이터셋으로 실제 분석에 들어갔다. 강사님이 사이킷런에서 받을 수 있는 csv 를 공유해주셔서 그걸 받아 썼다. 미리 설치해둔 Rainbow CSV 익스텐션 덕분에 색으로 구분돼서 잘 보였다.
Table of contents
Open Table of contents
csv 읽기
원래 파이썬에서 파일을 읽으려면 open 을 써야 하고 os 나 pathlib 도 필요하다. pandas 에는 read_csv 가 있어서 그럴 필요가 없다.
파일 위치는 변수에 담아두고 필요할 때 꺼내 쓴다. 한 번 만들고 안 바꿀 변수를 상수형 변수라고 하고, 보통 대문자로 쓴다. 경로는 상대 경로로 줬다.
df = pd.read_csv(IRIS_CSV_PATH)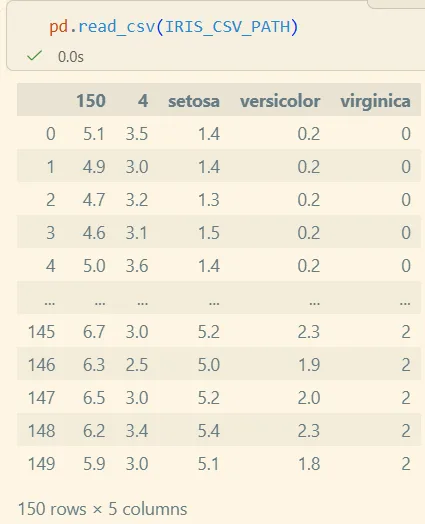
DataFrame 으로 읽어오긴 했는데 표가 이상하다.
첫 줄이 컬럼 이름으로 들어갔다
#4 에서 배운 대로 shape 부터 봤다. csv 의 첫 줄이 컬럼 이름으로 들어가 있었다. 헤더 자리에 150, 4, setosa, versicolor, virginica 가 앉아 있다.
그래서 첫 줄을 건너뛰게 했다.
df = pd.read_csv(
    IRIS_CSV_PATH,
    skiprows=1,
)
그런데 csv 는 계속 첫 줄을 제목으로 삼으려고 한다. 이번엔 데이터의 첫 행이 컬럼 이름이 된다. header 를 None 으로 줘야 한다.
df = pd.read_csv(
    IRIS_CSV_PATH,
    skiprows=1,
    header=None,
)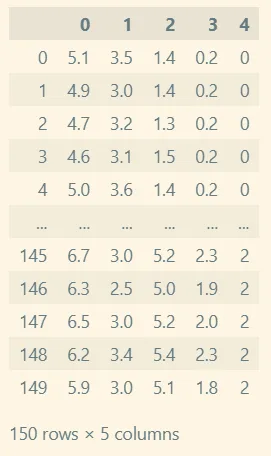
이렇게 하면 누락 없이 150 행이 들어온다. 대신 컬럼 이름이 없으니 직접 줘야 한다. Iris 데이터는 꽃받침 길이와 너비, 꽃잎 길이와 너비, 그리고 종이다. 분석하는 동안 바뀌지 않을 값이니 상수형 변수로 만들었다.
IRIS_COLUMNS = [
    "sepal_length", "sepal_width",              # 꽃받침 길이, 너비
    "petal_length", "petal_width", "species",   # 꽃잎 길이, 너비
]

df = pd.read_csv(
    IRIS_CSV_PATH,
    skiprows=1,
    header=None,
    names=IRIS_COLUMNS,
)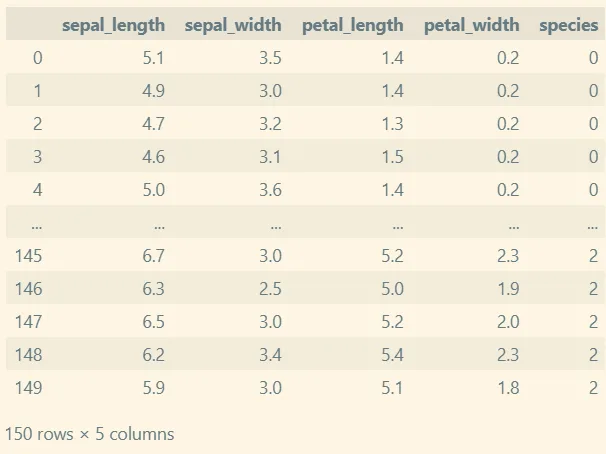
이제 info() 와 describe() 를 부를 수 있다.
csv 를 받지 않고 사이킷런에서 바로 가져올 수도 있다.
from sklearn.datasets import load_iris후load_iris()를 부르고, 그 데이터를 DataFrame 에 넣으면 된다.
결측치는 따로 확인한다
df.info() 로 봤을 때 결측이 없다고 나와도 확실하게 확인하는 게 좋다.
df.isna()         # 셀마다 결측 여부
df.isna().sum()   # 속성마다 결측이 몇 개인지
sum() 까지 붙이면 각 속성에 결측이 몇 개인지 숫자로 바로 나온다.
df.sample(n=5) 로 무작위 추출을 해도 한쪽으로 쏠릴 수 있으니 표본만 보고 판단하면 안 된다.
describe() 에 종까지 나온다
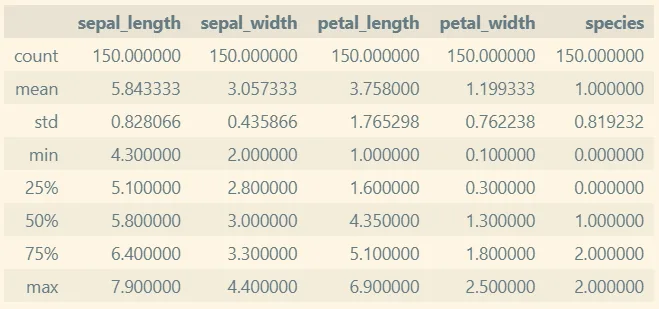
species 에도 평균과 표준편차가 나온다. 종은 범주형이라 기술통계가 필요 없는데도 계산된다. 값이 0 · 1 · 2 라는 숫자로 저장되어 있어서 pandas 가 수치형으로 보기 때문이다.
#1 에서 배운 식별자 함정과 같은 이야기다. 숫자처럼 보인다고 수량인 건 아니다.
기술통계에서 무엇을 보나
| 무엇을 | 왜 | 지표 |
|---|---|---|
| 중심경향치 | 데이터가 어디에 모여 있는가 | 평균(mean) · 중앙값(median) · 최빈값(mode) |
| 산포도 | 데이터가 어떻게 퍼져 있는가 | 분산(variance) · 표준편차(standard deviation) · 사분위수(quartile) |
| 분포의 형태 | 데이터가 어떤 모양인가 | 왜도 · 첨도 |
- 평균: 모든 값을 더한 뒤 개수로 나눈 값
- 중앙값: 크기 순서로 나열했을 때 정중앙에 있는 값
- 최빈값: 가장 자주 등장하는 값
- 분산: 평균에서 떨어진 정도를 제곱해서 구한 평균
- 표준편차: 분산의 양의 제곱근
- 사분위수: 전체를 4등분한 위치의 값
- 왜도: 분포가 한쪽으로 치우친 정도
- 첨도: 분포의 뾰족한 정도
이것들을 보고 이상치를 알 수 있다.
열 하나의 중앙값을 보려면 그 열을 Series 로 꺼내서 median() 을 부른다.
df["sepal_width"].median()np.float64(3.0)파이썬 float 이 아니라 np.float64 로 나온다. 정확도 때문이라고 한다.
파생 변수 — 원본은 두고 복사본에
범주형 데이터를 알아볼 수 있게 파생 변수를 만들어봤다. 먼저 딕셔너리로 종 번호와 붓꽃 이름을 매핑해뒀다.
중요한 건 원본은 그대로 두고 복사본에 파생 변수를 붙이는 것이다. df.copy() 를 쓴다.
복사에는 두 종류가 있다.
- 얕은 복사 — 주소만 복사한다 (참조)
- 깊은 복사 — 데이터까지 복사한다
df.copy() 는 아예 새로 만드는 쪽이다.
Series 에는 map() 이 있다. 매핑 딕셔너리를 넣으면 각 값을 해당하는 키의 문자열로 바꿔준다.
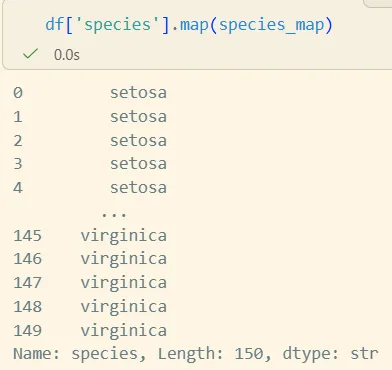
이걸 새 컬럼에 넣으면 파생 변수가 붙은 DataFrame 이 된다.
species_df['species_code'] = df['species'].map(species_map)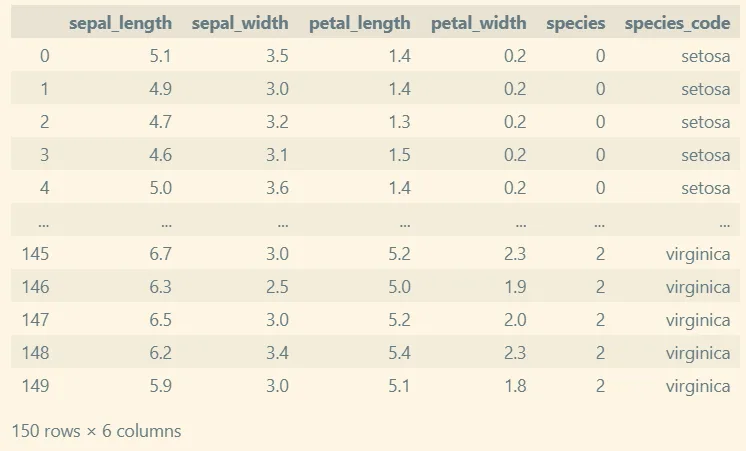
총계나 평균을 구할 때 이렇게 DataFrame 에 열을 추가해두고 쓰면 된다. 파생 변수를 붙이는 것까지 알았으니 지금 배운 것만으로도 분석할 준비는 된 셈이다.
범주별 개수 세기
범주형 데이터마다 몇 개씩 있는지는 value_counts() 로 본다.
species_df['species'].value_counts()species
0 50
1 50
2 50
Name: count, dtype: int64퍼센트로 보고 싶으면 normalize=True 를 준다.
species_df['species'].value_counts(normalize=True)아직 안 풀린 것 — “unknown”
결측치가 문자열 "unknown" 으로 들어 있다면, 우리 눈에는 결측치지만 프로그램 눈에는 아니다. isna() 를 돌려도 전부 False 가 나온다.
여기까지 확인하고 마무리하지 못했다.
더 공부해볼 것
- 문자열로 위장한 결측치 처리 —
"unknown"·"N/A"· 빈 문자열처럼 사람 눈에만 결측인 값을 어떻게 진짜 결측으로 바꾸는지. #1 에서 결측 표시가 통일되어 있지 않다고 배운 것의 실제 사례다.read_csv에na_values인자가 있다고 들었다 np.float64로 나오는 이유 — 정확도 때문이라고 들었는데 파이썬float과 실제로 무엇이 다른지 확인이 필요하다. numpy 자료형과 파이썬 자료형의 관계로 이어질 것 같다- 범주형인데 숫자로 저장된 열을 어떻게 표시하나 —
species가describe()에 끼어드는 걸 막으려면 자료형을 바꿔야 할 것 같다. pandas 에category라는 자료형이 있다고 들었다 (pandas categorical) - 왜도와 첨도를 실제로 어떻게 읽나 — 이름과 정의는 배웠지만 값이 얼마일 때 “치우쳤다” 고 보는지 기준을 모르겠다
skiprows와header의 관계 — 둘을 같이 줘야 했던 이유를 정리해둘 것.skiprows만 주면 왜 다음 줄이 다시 헤더가 되는지 (pandasread_csv)- 얕은 복사가 문제를 일으키는 경우 —
df.copy()를 쓰라고 배웠는데, 안 쓰면 실제로 어떤 사고가 나는지 직접 재현해볼 것