
이번에는 연습용 데이터가 아니라 부산항만공사의 실제 데이터를 받아봤다. 처음에는 부산항만공사에서 직접 받는 줄 알았는데, 확인해보니 공공데이터는 공공데이터포털에서 관리하고 있었다. 그래서 부산항만공사 데이터를 받으려면 포털로 가야 한다.
공공데이터포털에서 공공데이터 → 데이터 목록으로 들어가 “부산항만공사” 를 키워드로 검색했다. 여기서 부산항만공사_부산항 컨테이너 수송통계 를 csv 로 받았다.
Table of contents
Open Table of contents
환경 세팅에서 시간을 날렸다
uv init 과 uv add 로 초기 환경을 잡았는데, ipykernel 을 ipkernel 로 잘못 쳐서 한참 걸렸다.
PS C:\dev\d1> uv add pandas ipkernel numpy
Using CPython 3.14.7 interpreter at: C:\Users\user\AppData\Local\Programs\Python\Python314\python.exe
Creating virtual environment at: .venv
  ╰─▶ Because ipkernel was not found in the package registry and your
      project depends on ipkernel, we can conclude that your project's
      requirements are unsatisfiable.

hint: If you want to add the package regardless of the failed resolution, provide the `--frozen` flag to skip locking and syncing
메시지는 정확하게 “레지스트리에 그런 패키지가 없다” 고 알려주고 있었는데, 나는 해석을 못 하고 환경 문제인 줄 알았다. 패키지 이름을 못 찾겠다고 하면 오타부터 의심하는 게 맞다.
analysis.ipynb 로 노트북을 새로 만들고, D001_PATH 라는 상수에 경로를 적어둔 다음 pd.read_csv(D001_PATH) 로 불러왔다.
컨테이너 수송통계 훑기
지난 글에서 정리한 탐색 순서대로 하나씩 봤다.
df.head(5) 로 다섯 줄을 봤더니 1994년부터의 데이터가 나왔다. 최근에 생긴 부두라면 그 이전 연도에 결측치가 있을 법한데, 거기에도 0 이 채워져 있었다.
df.shape 는 (31, 15) 였고, 포털의 “전체 행 31” 과 일치했다.
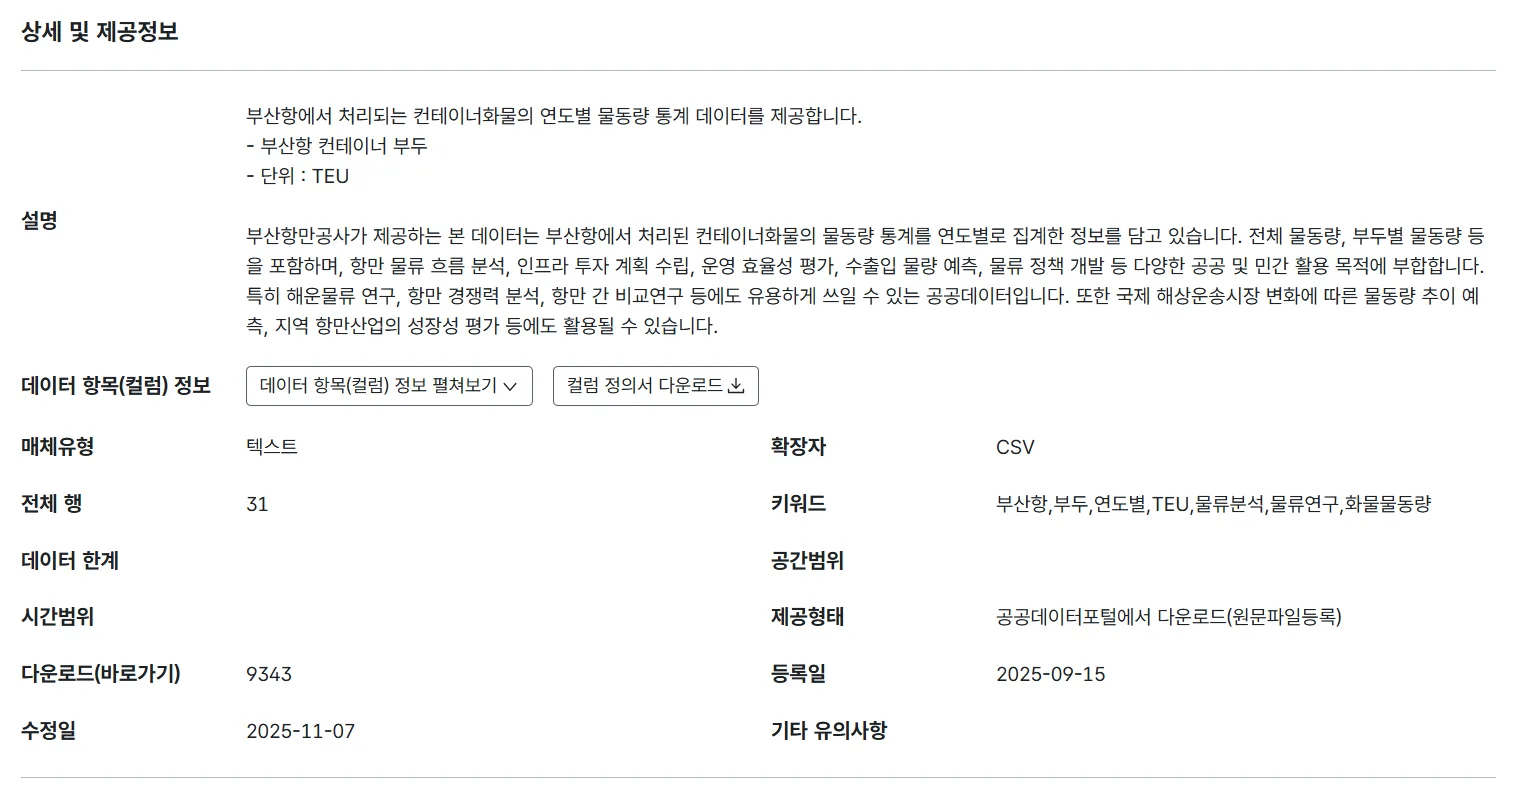
df.dtypes 를 봤더니 전부 정수였다. 결측치가 있었다면 NaN 때문에 실수형이 됐을 텐데 정수형이니까 결측치가 없다고 짐작할 수 있다.
df.info() 도 확인했다. 행이 31개니까 31년치 데이터다.
여기서 알아야 할 게 하나 있다. 연도는 숫자로 저장돼 있지만 합산하거나 평균을 낼 데이터가 아니다. 시간 축이고, 각 레코드를 식별해주는 인덱스가 될 수 있다. 이렇게 시간의 흐름대로 되어 있는 데이터를 시계열 데이터라고 한다.
개략을 한 번에 보기
단계별로 따로 확인하는 대신 한 번에 묶어서 볼 수도 있다.
pd.DataFrame({
    "자료형": df.dtypes.astype("str"),
    "비결측 수": df.notna().sum(),
    "결측 수": df.isna().sum(),
    "결측률(%)": df.isna().mean() * 100,
    "고유값 수": df.nunique(dropna=True)    # 결측치 빼고 고유값만
})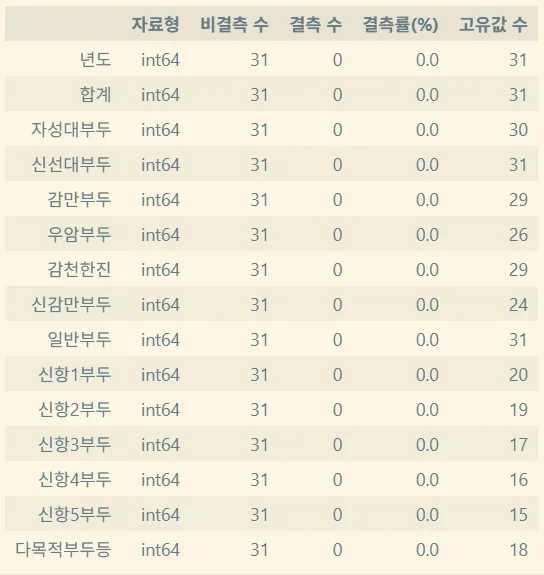
이렇게 출력하면 데이터의 개략을 한 화면에서 볼 수 있다. 고유값 수를 보면 신항 부두들이 20 이하로 낮은데, 나중에 생긴 부두라 앞쪽 연도가 전부 0 으로 채워져 있기 때문이다.
결측값까지 확인했으니 기술통계를 볼 차례다. 그런데 그냥 df.describe() 를 하니 지저분하다. df.describe().T 로 전치하니 그나마 볼 만해졌다. 축이 헷갈릴 때뿐 아니라 이럴 때도 전치를 쓴다.
합계가 무엇의 합계인지 모르겠다
훑다 보니 답답한 게 있었다. 컬럼에 부두 이름만 쭉 나열돼 있고 단위가 없다. “합계” 도 무엇을 합친 건지 파일만 봐서는 모르겠다.
찾아보니 포털 상세 페이지에는 다 적혀 있었다. 설명란에 단위: TEU 라고 있고, 컬럼 정의서를 따로 내려받을 수도 있다. 즉 메타데이터가 없는 게 아니라 csv 파일 안에 없는 것이었다. 파일만 받아두면 다음에 열었을 때 또 똑같이 헤맨다.
그래서 데이터 옆에 메타데이터를 직접 만들어두기로 했다. 단위가 무엇인지, 각 코드가 어떤 값인지 적어두는 게 좋다. 지금은 컬럼이 15개뿐이라 별거 아닌 것 같지만, 나중에 이 데이터를 다시 열었을 때 나를 살리는 건 이 메모다.
단위를 줄이고 증감률 보기
합계가 너무 커서 e+05 같은 지수 표기로 나왔다. 그래서 구간을 잘라 범주화했다.
total = df["합계"]

total_band = pd.cut(
    total,
    [0, 5_000_000, 10_000_000, 15_000_000, 20_000_000, float("inf")],
    labels=["500만 이하", "500만~1000만", "1000만~1500만", "1500만~2000만", "2000만 초과"]
)
그리고 기점을 정해서 잘랐다.
df[df["년도"].ge(2000)]2000년이라는 기점은 내가 정한 것이다. 2000년부터 전년 대비 증감률을 계산해서 얼마나 성장했는지 보는 게 목표였다. 이 데이터프레임을 stable 에 담았다.
stable["합계"].pct_change() # 전년도 기준 증감률전년도 기준이라 첫 데이터가 NaN 으로 나온다. 그래서 dropna() 를 붙인다.
stable["합계"].pct_change().dropna()그런데 연도별 데이터는 편차가 너무 커서, 이걸로 항만 처리량이 어떻다고 말하기에는 과소평가될 가능성이 있었다.
질문을 갈아엎었다
처음에 보려던 건 연간 물동량 처리로 부산항의 효율을 보는 것이었는데, 이 데이터가 거기에 적합하지 않다는 결론이 나왔다.

어느 항구가 가장 많은 빈도를 나타내는지를 보는 게 낫겠다고 판단했다. 전체 부두 합계를 내고 신항 부두 합계를 낸 다음, 어느 쪽이 더 많이 쓰이는지 보면 컨테이너 수송 효율을 내려면 어떤 항만을 이용해야 하는지 알 수 있다.
terminal_col = []

for column_name in df.columns:
    if column_name not in ["년도", "합계"]:
        terminal_col.append(column_name)
new_port = []
for column_name in df.columns:
if column_name.startswith("신항"):
new_port.append(column_name)이렇게 전체 부두 이름과 신항 이름을 각각 담았다. 이제 합계를 낸다.
df[terminal_col].sum(axis=1)    # 연도별 부두 합계
df[new_port].sum(axis=1)        # 연도별 신항 합계
행마다 하나씩 값이 나와야 하니까 axis=1 이다. 지난 글에서 헷갈렸던 부분이 여기서 바로 쓰였다.
이 합계들을 파생 변수로 추가하고, 신항합계를 부두합계로 나눠 신항비중까지 넣었다.
df_1[["년도", "부두합계", "신항합계", "신항비중"]]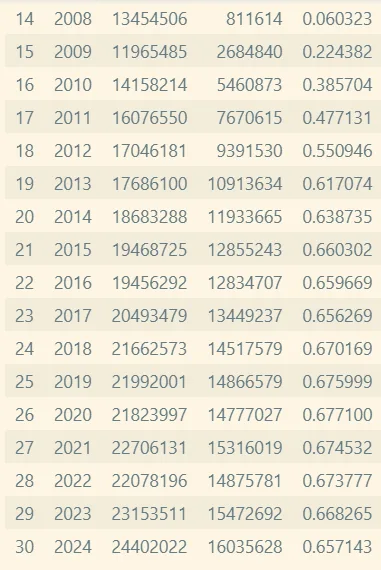
신항이 생긴 이후로 비중이 계속 높아질 거라고 예상했는데, 어느 정도까지 오르고 나서는 유지하는 추세를 보였다. 2015년에 0.66 을 찍은 뒤로 10년 가까이 0.65~0.68 사이에 머물러 있다.
데이터를 보면 컨테이너 물동량 처리 비중이 어느 순간부터 정체돼 있다는 건 알 수 있다. 다만 왜 정체돼 있는지는 이 데이터만으로는 모른다. 다른 데이터를 봐야 한다.
연습해볼 만한 게 두 개 더 있다. 2024년 물동량이 어느 부두에 집중돼 있는지는 연도별 최대값을 보면 되고, 신항이 언제부터 부산항의 중심이 됐는지는 방금 구한 비중으로 바로 답할 수 있다.
선박 입출항 데이터 — 인코딩부터 막혔다
이번에는 부산항만공사_선박 입출항 집계 정보 를 받았다.
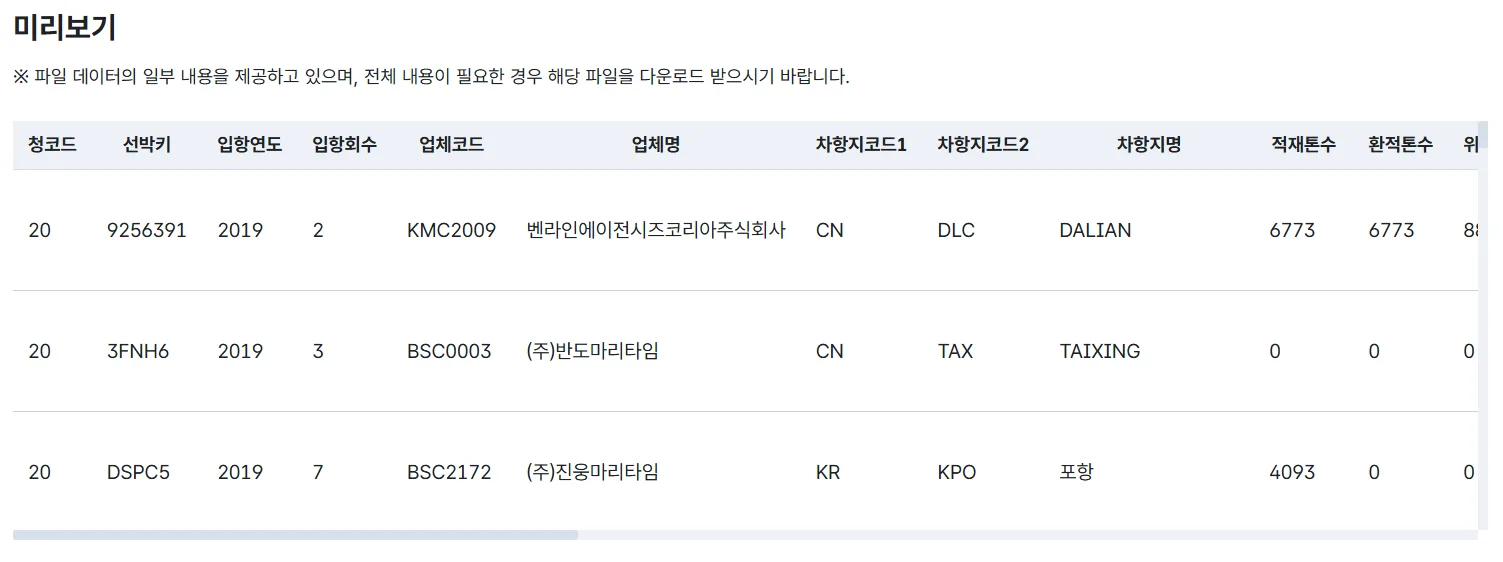
먼저 용어부터 정리했다.
- 차항지: 어디로 갈 건지
- 전출항지: 어디에서 왔는지
그런데 읽자마자 에러가 났다.
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc4 in position 2: invalid continuation byteread_csv 는 기본적으로 UTF-8 로 읽는데, 이 파일은 CP949(EUC-KR 계열) 로 인코딩돼 있었다. UTF-8 로 해석할 수 없는 바이트를 만나서 터진 것이다. 인코딩을 지정해주면 된다.
pd.read_csv(FILE_PATH, encoding="cp949")에러 메시지를 다시 읽어보면 답이 그대로 들어 있다. “utf-8 코덱이 못 읽는 바이트가 있다” 는 건 파일이 UTF-8 이 아니라는 뜻이다.
결측치로 데이터가 갈린다
df.head() 와 df.shape 로 확인하고 df.info() 를 봤더니, non-null 수가 컬럼마다 다른 게 눈에 띄었다. 아까 만든 요약표를 그대로 다시 썼다.
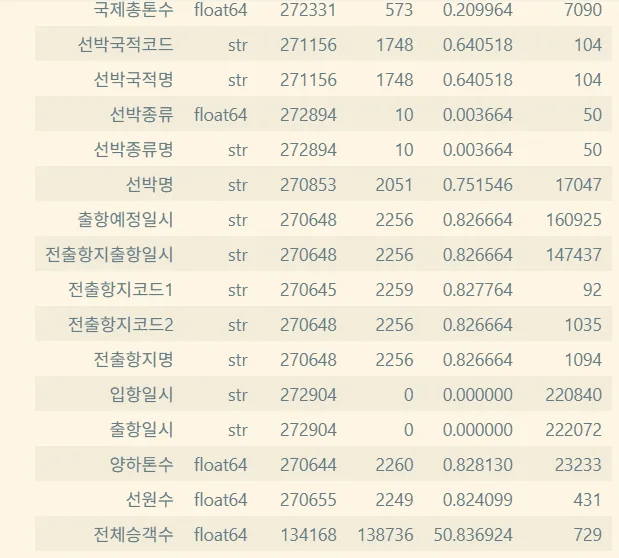
전체승객수의 결측률이 50.8% 로 유독 높다. 여객선과 화물선이 한 테이블에 섞여 있어서인 것 같다. 화물선에는 승객 수가 있을 이유가 없다. 그렇다면 이 결측치가 있느냐 없느냐로 여객선 데이터와 화물선 데이터를 나눌 수도 있겠다는 생각이 들었다. 확인은 필요하다.
df.describe().T 를 해보니 데이터가 좀 이상했다. 전체 톤수는 큰데 양하 톤수와 환적 톤수가 너무 적다. 결측치도 아까 데이터와 달리 있어서 처리가 필요하다.
계류시간 구하기
결측치 처리는 뒤로 미루고 쉬운 것부터 했다. 계류시간, 즉 배가 항구에 머무는 시간이다.

문자열을 시간 데이터로 바꾸는 건 to_datetime() 이 해준다.
pd.to_datetime(df["입항일시"])입항일시는 결측치가 없어서 한 번에 됐는데, 결측치가 있는 경우에는 파라미터를 붙여줘야 한다.
pd.to_datetime(df["입항일시"], errors="coerce")변환하고 나면 연·월·일·시·분이던 문자열이 초까지 있는 시간 데이터로 바뀐다. 출항일시도 결측치가 없어서 똑같이 해줬다.
출항시간에서 입항시간을 빼면 시리즈가 나오는데, 시간이 아니라 “며칠 몇 시간” 형태다.
0         1 days 00:00:00
1         0 days 15:00:00
2         0 days 10:00:00
3        11 days 13:45:00
4         0 days 16:00:00
               ...
272903   14 days 00:00:00
Length: 272904, dtype: timedelta64[us]
이걸 초로 바꾼다. 시리즈의 dt.total_seconds() 를 쓰면 된다.
0           86400.0
1           54000.0
2           36000.0
3          999900.0
4           57600.0
            ...
272903    1209600.0
Length: 272904, dtype: float64
여기에 3600을 나눠주면 계류시간이 몇 시간인지 나온다.
필터가 전부 False 였다
계류시간을 봤더니 너무 긴 데이터가 있었다. 문제 있는 데이터라고 보고 걸러내려 했다.
invalid = arrival.dt.year.eq(df["입항일시"]) & stay.between(0, 24 * 30)

invalid
0 False
1 False
2 False
3 False
4 False
...
272903 False
Length: 272904, dtype: bool전부 False 로 나왔다. 걸리는 게 없으니 문제 있는 데이터가 없구나 하고 넘어갔다.
그런데 뒤에서 요약표를 만들어보니 이야기가 달랐다.
pd.Series({
    "원본 행 수": len(df),
    "입항연도와 입항일시 연도 불일치": df["입항일시"].dt.year.ne(df["입항연도"]).sum(),
    "음수 체류시간": df["체류시간"].lt(0).sum(),
    "30일 초과 체류시간": df["체류시간"].gt(24 * 30).sum(),
    "유효 체류시간 비율": valid_stay.mean() * 100,
    "완전중복행": df.duplicated().sum()
})
원본 행 수 272904.000000
입항연도와 입항일시 연도 불일치 214.000000
음수 체류시간 19.000000
30일 초과 체류시간 4838.000000
유효 체류시간 비율 98.153197
완전중복행 0.000000
dtype: float6430일을 넘긴 게 4838건이다. 아까 아무것도 안 걸렸던 게 이상하다.
원인은 앞의 조건식에 있었다. arrival.dt.year 는 연도라서 정수인데, 이걸 df["입항일시"] 와 비교했다. 입항일시는 시간 타입이다. 비교 대상이 애초에 어긋나 있었다.
여기서 짚어야 할 건, 이게 에러로 터지지 않았다는 점이다. 직접 확인해봤다.
s = pd.Series(pd.to_datetime(["2019-01-01", "2020-05-05"]))
y = s.dt.year

y.eq(s)   # [False, False]  — 조용히 전부 False
y > s     # TypeError
== 이나 .eq() 는 타입이 안 맞으면 예외를 내지 않고 전부 False 를 돌려준다. 부등호였다면 TypeError 로 바로 터졌을 것이다. 그리고 이 False 가 & 로 묶여 있으니 뒤에 뭘 붙이든 결과는 전부 False 다.
비교하려던 건 입항일시에서 뽑은 연도와 별도 컬럼인 입항연도였다. 요약표에 쓴 게 맞는 형태다.
arrival.dt.year.ne(df["입항연도"]) # 214건“아무것도 안 걸렸다” 는 결과를 데이터가 깨끗한 증거로 받아들이면 안 된다. 필터가 동작하지 않은 것과 걸릴 게 없는 것은 화면에서 똑같이 생겼다. 조건을 하나씩 떼서 개수를 세보면 바로 드러났을 텐데 그러지 않았다.
기준은 내가 정한다
이상값 기준도 정리해뒀다. 출항일시에서 출항예정일시를 빼서 출항지연시간을 구했더니 마이너스가 나오는데, 예정보다 일찍 나간 것이라 지연으로는 쓰지 않는다.
체류시간 30일은 배를 고치느라 길어진 것으로 보여서 잡은 선이다. 데이터에 정해져 있는 값이 아니라 내가 개인적으로 정한 기준이다.
데이터가 잘 담겨 있는 것처럼 보여도 이렇게 모순된 값이 섞여 있다. 마스킹해서 잘 걸러내야 한다.
정리
- 공공데이터포털의 상세 페이지에는 단위와 컬럼 정의서가 있다. csv 파일에는 없으니 옆에 따로 적어둔다
- 세운 질문에 데이터가 안 맞으면 질문을 바꾼다. 물동량으로 효율을 보려다 신항 비중으로 갈아탔다
read_csv의 기본 인코딩은 UTF-8 이다. 국내 공공데이터는 CP949 인 경우가 많다- 필터 결과가 전부
False면 데이터를 의심하기 전에 조건식부터 의심한다
더 공부해볼 것
- pandas 의 비교 연산이 타입 불일치를 다루는 방식 —
==는 조용히False, 부등호는TypeError였다. 왜 다르게 처리하는지, 그리고 이런 실수를 미리 잡아주는 방법이 있는지 알고 싶다. → pandas: Comparisons - 결측 패턴으로 데이터를 나누는 게 타당한가 — 전체승객수 결측을 화물선으로 간주하려면 그 결측이 정말 “해당 없음” 인지 확인해야 한다. 결측이 왜 생겼는지에 따라 처리가 달라진다고 한다. → Working with missing data
pd.cut과pd.qcut의 차이 — 이번에는 500만 단위로 직접 구간을 잘랐는데, 분위수로 자르는 방법도 있다. 어떤 상황에 뭘 써야 하는지 궁금하다. → pandas.qcutpct_change()말고 성장률을 보는 방법 — 연도별 편차가 커서 전년 대비 증감률로는 판단이 어려웠다. 여러 해에 걸친 성장을 볼 때 쓰는 지표(CAGR 같은 것)를 찾아보고 싶다. → pandas.DataFrame.pct_change- 데이터 사전 만드는 법 — 컬럼별 단위·코드 의미·수집 주기를 어떤 형식으로 남겨두는 게 표준인지 보고 싶다. 지금은 그냥 마크다운에 적을 생각인데 정해진 형식이 있을 것 같다.
- 신항 비중이 왜 정체됐는가 — 이 데이터만으로는 답이 안 나온다. 접안 능력이나 선석 수 같은 다른 데이터를 붙여봐야 할 것 같다.