
또 오랜만에 블로그를 쓰게 된다. 이번 주에 취업을 해서 퇴근 후 공부한 걸 블로그에 쓰고 싶었지만, 업무 관련한 도메인 파악과 기술 파악에 시간을 쏟느라 따로 공부하지는 못했다. 공부도 해야 하고 운동도 해야 하는데 시간이 너무 모자라는 것 같다.
Table of contents
Open Table of contents
공부할 순서
그래프 RAG 쪽을 보게 돼서 순서를 잡아뒀다.

2번이 궁금해서 넣었다. 예전에 Chroma 로 블로그 QA 를 만들어본 적이 있는데, 그때는 벡터 DB 가 따로 있었다. 벡터와 그래프를 굳이 한 DB 에 넣는 이유가 뭔지 아직 모르겠다.
4번의 vLLM 도 처음이다. 지금까지는 Anthropic API 만 써봤지 모델을 직접 서빙해본 적이 없다.
오늘은 1일차라 Neo4j 그래프 기초를 한다.
Neo4j 설치 — Aura 무료 티어
Neo4j 는 두 가지가 있다.
- Neo4j Desktop: 로컬 개발용
- Neo4j Aura: 클라우드 버전
Aura 무료 티어를 추천받아서 계정을 만들고 무료 인스턴스를 하나 생성했다. 깃허브 계정으로 가입했다.
가입하다 보면 Region 을 고르는 단계가 나온다. Cloud 는 AWS / Azure / GCP 가 있는데 한국 서버는 Azure 밖에 없다. 그런데 나는 여기서 “another~” 어쩌고를 눌러버렸다. 다른 플랜을 보는 버튼이었고, 화면이 넘어간 뒤에 Free 를 누르고 그냥 Create 를 눌러서 지역 설정이 안 된 채로 인스턴스가 생성됐다. 어차피 학습용이니까 상관없겠지 뭐.
인스턴스를 만들고 나서 상태가 Running 으로 바뀔 때까지는 시간이 좀 걸리는 편이었다.
그래프 DB 는 관계형 DB 와 뭐가 다른가
- 관계형 DB (MySQL 등): 테이블 + 외래 키로 관계를 표현한다. “라인 A 가 어떤 설비를 쓰는지” 알려면
JOIN을 해야 한다 - 그래프 DB (Neo4j): “라인 A 가 어떤 설비를 쓰는지” 가 애초에 화살표(엣지)로 저장돼 있어서
JOIN없이 바로 따라간다

3-hop, 5-hop 관계 조회가 훨씬 빠르고 직관적이라고 한다. 얼마나 빨라지는지는 아직 직접 재보지 않았다.
Cypher 첫 쿼리
Cypher 가 뭔지부터 봤다. Cypher 는 Neo4j 의 쿼리 언어다. 관계형 DB 에서 SQL 을 쓰듯이, 그래프 DB 인 Neo4j 에는 Cypher 를 쓴다.
스프링부트 할 때 배운 SQL은 이런 문법이었다.
SELECT * FROM line WHERE name = '라인1';Cypher 는 테이블이 아니라 노드와 관계를 다룬다. 그림을 그리듯이 쓰는 것이 Cypher 문법의 핵심 아이디어다.
(l:Line {name: '라인1'})-[:USES]->(e:Equipment {name: '가열로'})코드를 읽을 줄 알면 그림이 보인다고 한다.
(라인 1) --USES--> (가열로)직접 만들어보기
Cypher 쿼리를 아까 만든 인스턴스에서 실행하려면 먼저 Connect 를 해야 한다. 나는 Studio 의 Query 탭으로 들어가서 상단에서 아까 만든 인스턴스를 연결했다. 그리고 Create query 를 누르고 쿼리를 입력했다.
노드 만들기
CREATE (l:Line {name: '열간단조 라인1', rated_power_kw: 300})
CREATE (e:Equipment {name: '가열로', type: '가열'})
CREATE (a:Alarm {message: '온도 초과', severity: 'high', timestamp: '2026-09-01'})
CREATE 는 그래프 DB 의 노드를 만드는 건데 SQL 의 INSERT 로 이해하면 된다고 한다. 하나씩 뜯어보면 이렇다.
(l:Line {...})에서 소괄호가 노드를 가리킨다l은 alias 같은 역할이다Line은 레이블이라고 부르는데 SQL 의 테이블명 역할을 한다- 중괄호 안이 그 노드의 속성이다
위 명령어로 노드 세 개를 만들었다.
관계 만들기
MATCH (l:Line {name: '열간단조 라인1'}), (e:Equipment {name: '가열로'})
CREATE (l)-[:USES]->(e)
MATCH 는 SQL 의 SELECT ... WHERE 과 같은 것이다. [:USES] 는 관계를 나타내고 화살표는 방향을 나타낸다. 위 쿼리를 해석하면 l 이 e 를 USES 한다는 관계선을 긋는다는 뜻이다.
MATCH (e:Equipment {name: '가열로'}), (a:Alarm {message: '온도 초과'})
CREATE (e)-[:TRIGGERED]->(a)
이번에는 [:USES] 대신 [:TRIGGERED] 를 썼다. 알고 보니 USES 라고 하는 게 컬럼명처럼 사용자가 편한 대로 붙이는 방식이었다. 관례상 관계는 대문자 + 언더스코어로 쓰고, 노드 레이블은 파스칼 케이스로 쓴다고 한다.
조회하기
MATCH (l:Line {name: '열간단조 라인1'})-[:USES]->(e:Equipment)-[:TRIGGERED]->(a:Alarm)
RETURN l.name, e.name, a.message, a.severity
앞에서 실행한 것과 뭐가 다른지 봤다. 앞의 [:USES] 와 [:TRIGGERED] 는 관계를 생성하는 것이었고, 이 MATCH 구문에 있는 건 DB 안에 이런 패턴이 있으면 찾아서 보여달라고 조회한 것이라고 한다.
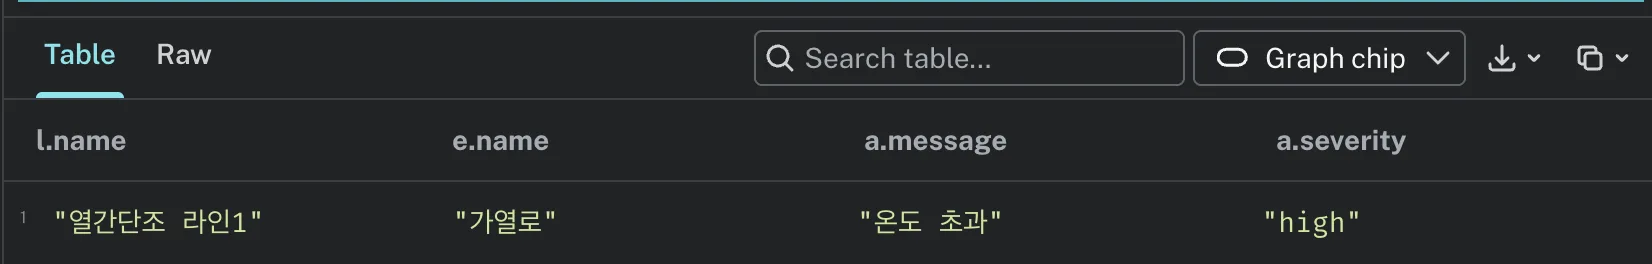
결과로 이런 로그를 볼 수 있었다.
그래프가 안 나왔다
그런데 그래프가 나오지 않았다. 표만 나왔다.
위 결과는 속성만 따로 뺀 것이기 때문에 그래프가 나오지 않았던 것이다. l.name 은 그냥 문자열이라 Studio 입장에서는 그릴 게 없다. 노드와 관계 자체를 반환해야 그래프 뷰가 보인다.
MATCH path = (l:Line {name: '열간단조 라인1'})-[:USES]->(e:Equipment)-[:TRIGGERED]->(a:Alarm)
RETURN path
MATCH 에 path = 를 붙여서 경로 전체에 이름을 주고, 그 경로를 그대로 반환했다. 이번에는 그래프 뷰가 보였다.
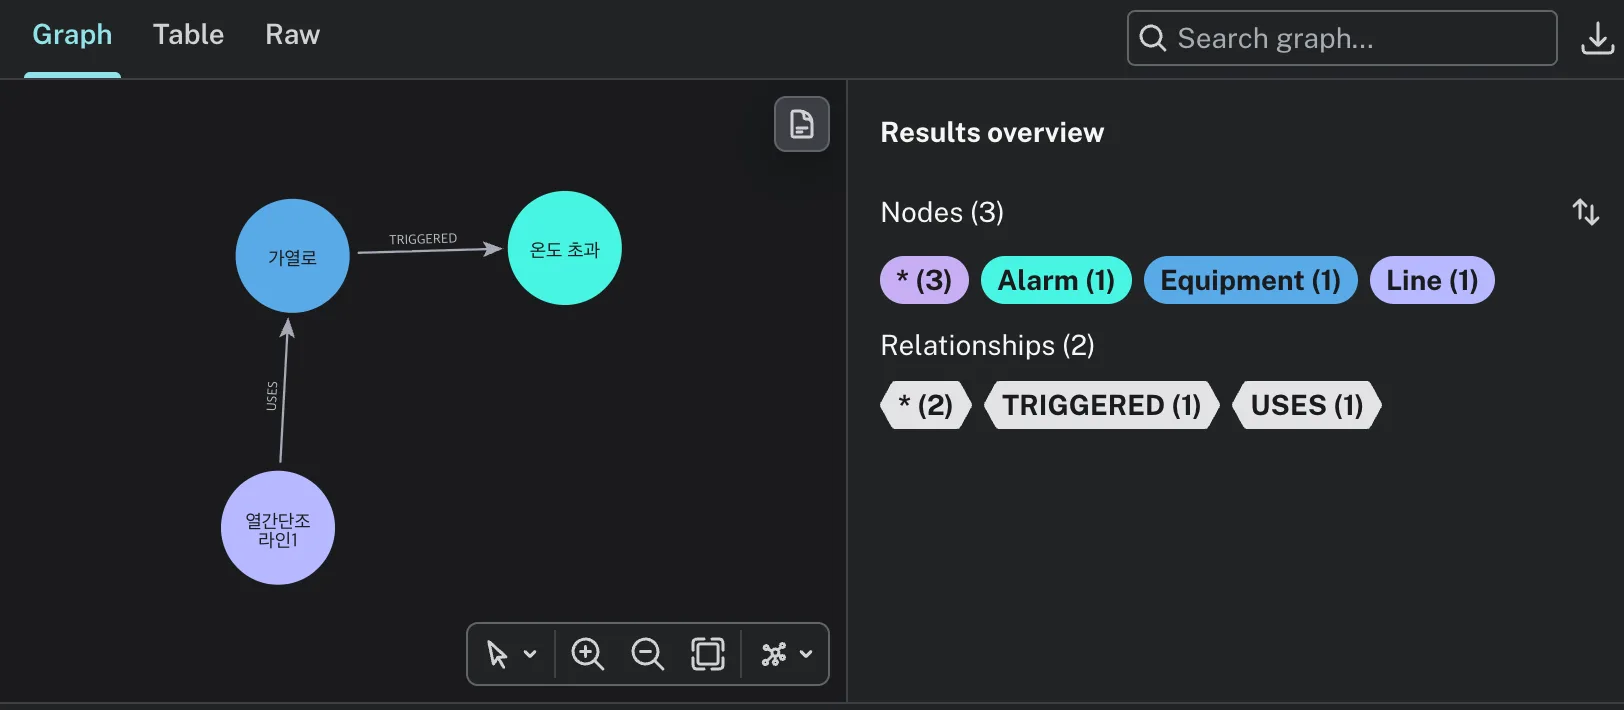
쿼리가 틀린 게 아니라 RETURN 에 무엇을 넘기느냐의 문제였다. 같은 MATCH 라도 속성을 꺼내면 표, 노드나 경로를 꺼내면 그래프다.
언제 Table 을 쓰고 언제 Graph 를 쓰는지도 같이 알아봤다.
| 목적 | RETURN 에 넘기는 것 | 뷰 |
|---|---|---|
| 값만 뽑을 때 | l.name, a.severity | Table |
| 노드 · 관계 자체를 볼 때 | l, e, a 또는 path | Graph |
이번에 배운 건 여기까지다. 공부하는 건 재밌는데, 확실히 공부한 걸 기록으로 옮기려다 보니 그게 너무 어려운 것 같다.
더 공부해볼 것
JOIN3번과 3-hop 탐색이 실제로 얼마나 차이 나는가 — “훨씬 빠르다” 고만 듣고 넘어갔는데 직접 재보지 않았다. 데이터가 적을 때도 차이가 나는지, 어느 규모부터 벌어지는지 보고 싶다 → Neo4j: Graph database concepts- 벡터와 그래프를 왜 한 DB 에 넣는가 — 로드맵 2번에 넣어둔 의문이다. Chroma 를 따로 쓰는 것과 비교해서 뭐가 나아지는지 → Neo4j: Vector indexes
MERGE와CREATE의 차이 — 오늘은CREATE만 썼는데, 같은 노드를 두 번 만들면 중복으로 쌓이는 건지 궁금하다 → Cypher: MERGE- 관계에도 속성을 넣을 수 있는가 — 노드에는 중괄호로 속성을 줬는데,
[:TRIGGERED]같은 관계에도 시각 같은 걸 달 수 있는지 - 인스턴스 Region 을 나중에 바꿀 수 있는가 — 지역 설정을 놓친 채로 만들었다. 학습용이라 상관없다고 넘겼지만, 옮길 수 있는지 아니면 다시 만들어야 하는지는 확인해두는 게 좋겠다