
오늘은 Neo4j 벡터 인덱스를 공부했다. 이전에 Chroma 로 벡터 검색을 했었는데 그걸 그래프 DB 안에서 하는 것 같다. 지난 글에서 “벡터와 그래프를 왜 한 DB 에 넣는가” 를 의문으로 남겼는데, 그거랑 이어지는 주제다.
Table of contents
Open Table of contents
벡터 인덱스 만들기
먼저 벡터 인덱스를 만든다.
CREATE VECTOR INDEX equipmentEmbeddings
FOR (n:Equipment)
ON (n.embedding)
OPTIONS {indexConfig: {
  `vector.dimensions`: 1536,
  `vector.similarity_function`: 'cosine'
}}
쿼리를 봤을 때 1536차원, 코사인 유사도를 쓴다는 게 바로 눈에 들어왔다. 인덱스 이름인 equipmentEmbeddings 는 사용자가 짓는 것이다.
신기했던 건 n:Equipment 부분이다. n 을 지역 변수처럼 써서 이 쿼리 안에서만 가리킨다고 한다. 그래서 전체를 읽으면 Equipment 노드의 embedding 속성에 벡터 인덱스를 거는데, 차원은 1536 이고 코사인 유사도를 쓴다는 뜻이 된다.
1536 이라는 숫자는 임베딩 모델에서 온다. 코드를 보니 text-embedding-3-small 을 쓰고 있었고, 아래에서 실제로 저장된 벡터 길이를 찍어보니 1536 이었다.
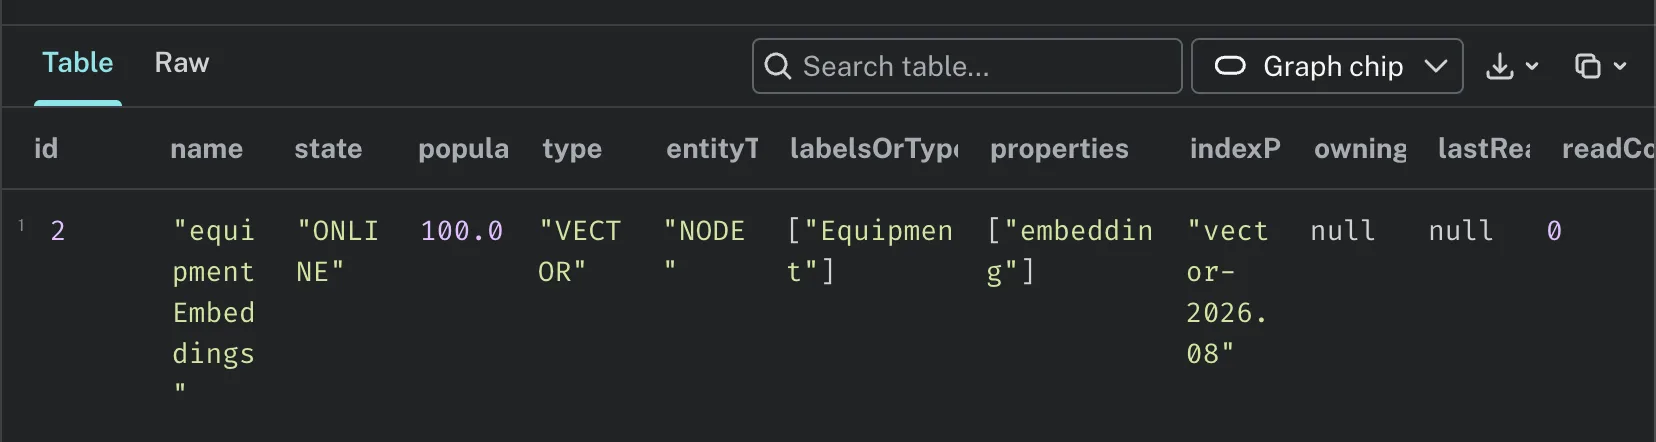
SHOW VECTOR INDEXES 로 방금 만든 인덱스가 목록에 뜨는지 확인했다.
프로젝트 준비
uv 로 환경을 세팅했다. uv init → uv venv → source .venv/bin/activate → uv pip install 순으로 진행했다. 맥북이라서 리눅스처럼 source .venv/bin/activate 를 써야 했다.
.env 파일을 만들어서 저장해둔 Neo4j 의 URI · Username · Password 와 OpenAI API 키를 넣었다. 그리고 add_embeddings.py 를 만들었다. 코드는 ai-study 저장소에 올렸다.
사용자명에 인스턴스 이름을 넣었다
처음 실행할 때 에러가 났다. permission/access denied 라는 문구가 보여서 .env 에 값을 잘못 넣었나 싶었다.
USERNAME 자리에 인스턴스의 이름을 넣었었는데, 이걸 인스턴스 ID 로 바꿔 넣으니까 임베딩이 성공했다.
임베딩은 당연히 Neo4j Aura DB 에 저장된다. 확인하려고 아래 쿼리를 실행했다.
MATCH (e:Equipment {name: '가열로'})
RETURN e.name, e.description, size(e.embedding) AS embedding_dimensions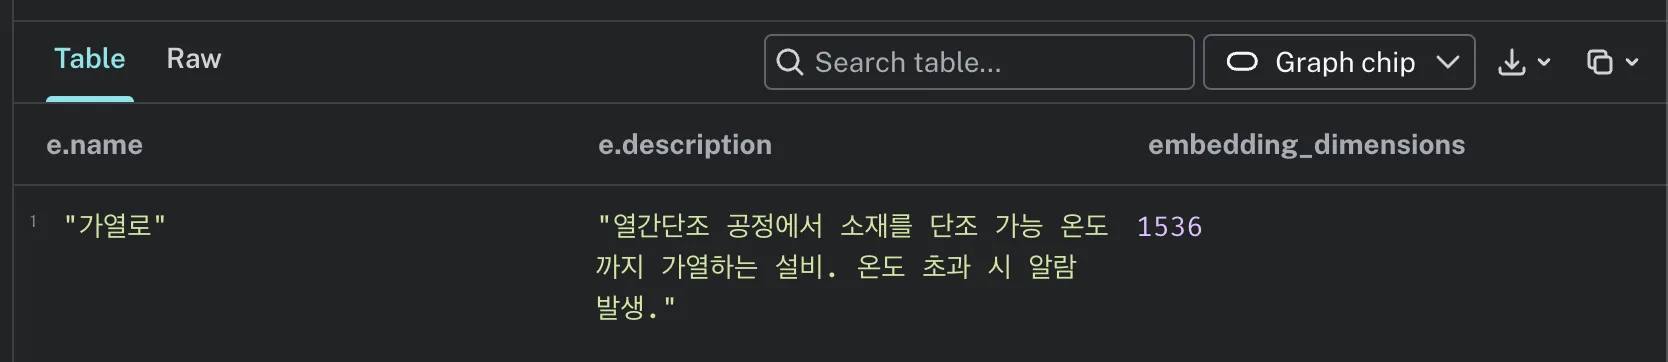
설명 텍스트를 임베딩한 결과가 보였다.
임베딩이 노드에 붙는다
여기서 짚고 넘어갈 게 있다. Chroma 에서는 임베딩을 컬렉션에 따로 저장했는데, Neo4j 에서는 노드의 속성으로 붙인다. 그래서 벡터와 그래프가 같은 노드에 공존할 수 있다.

벡터 검색 — 질문도 임베딩해야 한다
다음은 벡터 검색이다. 검색 코드가 따로 떨어져 있길래 임베딩 코드에 같이 붙여 쓰면 되나 했는데, 파일을 분리해야 했다. 그러면서 데이터를 두 개 더 만들고 Neo4j Browser 에서 노드도 두 개 추가했다. 노드를 추가했으니 임베딩 코드를 다시 돌려서 벡터를 만들었다.
하나 배운 건 검색할 때도 임베딩을 만들어야 한다는 거다. 질문도 벡터로 바뀌어야 유사도를 비교할 수 있기 때문이다.
Browser 에서 쓰는 쿼리와 코드 안의 쿼리
코드를 작성하다 보니 함수 안에 쿼리가 다 들어가 있었다. 쿼리가 스크립트 안에 다 있다면 이제 인스턴스의 쿼리 탭에 들어가 직접 입력할 일은 없는 건지 궁금했다.
결론은 둘 다 같은 DB 에 쿼리를 보내는 건 같은데 용도가 다르다고 한다.
| 쓰는 때 | |
|---|---|
| Neo4j Browser | 탐색할 때, 결과를 눈으로 확인할 때 |
| 파이썬 코드 | 로직이 정해졌고 그걸 반복해서 실행할 때 |
이해하려고 Browser 에서 쿼리 몇 가지를 써본 거지, 실제 서비스로 돌리려면 파이썬으로 실행할 수 있게 준비해둬야 한다.
SEARCH 쿼리 읽기
검색 함수에 이 쿼리가 들어 있었다.
SEARCH equipmentEmbeddings NEAREST $k NODES TO $embedding
        YIELD node, score
        RETURN node.name AS name, node.description AS description, score
쿼리만 보고 추측하면, equipmentEmbeddings 벡터 인덱스에서 질문 벡터와 가까운 노드 k 개를 찾고, 그 노드에서 이름 · 설명 · 점수를 뽑아달라는 것이다.
SEARCH 는 MATCH 와 다르다. MATCH 는 이런 관계가 있으면 찾아달라는 것이고, SEARCH 는 벡터 인덱스를 통해 가까운 걸 찾아달라는 것이다.
YIELD 가 가장 감이 안 왔는데, 간단히 말하면 검색이 내놓는 결과 중에 무엇을 받아올지 선언하는 절이다. 받아온 걸 다음 줄의 RETURN 에서 쓰겠다는 뜻이다.
SEARCH 가 문법 에러였다
그런데 에러가 났다.
neo4j.exceptions.CypherSyntaxError: {neo4j_code: Neo.ClientError.Statement.SyntaxError} {message: Invalid input 'SEARCH': expected 'ALTER', 'ORDER BY', 'CALL', 'CREATE', 'LOAD CSV', 'START DATABASE', 'STOP DATABASE', 'DEALLOCATE', 'DELETE', 'DENY', 'DETACH', 'DROP', 'DRYRUN', 'FILTER', 'FINISH', 'FOR', 'FOREACH', 'GRANT', 'INSERT', 'LET', 'LIMIT', 'MATCH', 'MERGE', 'NODETACH', 'OFFSET', 'OPTIONAL', 'REALLOCATE', 'REMOVE', 'RENAME', 'RETURN', 'REVOKE', 'ENABLESERVER', 'SET', 'SHOW', 'SKIP', 'TERMINATE', 'UNWIND', 'USE', 'WHEN', 'WITH' or '{' (line 2, column 9 (offset: 9))
"        SEARCH equipmentEmbeddings NEAREST $k NODES TO $embedding"
         ^} {gql_status: 42001} {gql_status_description: error: syntax error or access rule violation - invalid syntax}
SEARCH 를 예약어로 인식하지 못하고 있다. 아직 Cypher 25 의 SEARCH 를 지원하지 않는 문제라고 하는데, 결국 구버전 문법을 쓰고 있어서 생긴 문제다. 구버전 호환 문법으로 바꾸고 나서 해결됐다.
CALL db.index.vector.queryNodes('equipmentEmbeddings', $k, $embedding)
        YIELD node, score
        RETURN node.name AS name, node.description AS description, score
SEARCH 구문 대신 CALL db.index.vector.queryNodes 가 들어갔다.
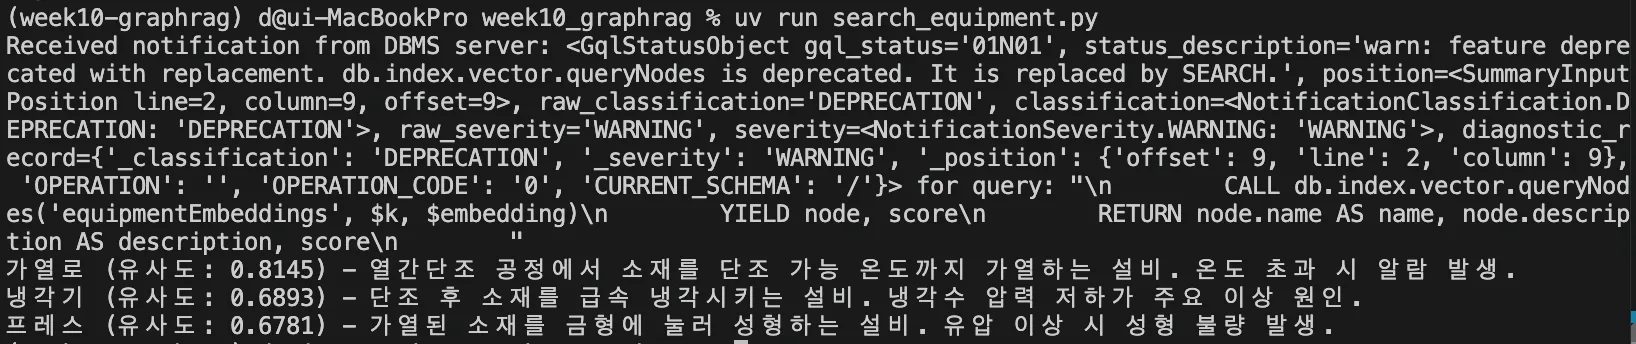
질문이 “온도 문제로 알람이 발생하는 설비” 였다. 그래서 유사도가 가장 높은 걸로 가열로가 나왔다. 맞게 나온 것이다.
가열로 (유사도: 0.8145) - 열간단조 공정에서 소재를 단조 가능 온도까지 가열하는 설비. 온도 초과 시 알람 발생.
냉각기 (유사도: 0.6893) - 단조 후 소재를 급속 냉각시키는 설비. 냉각수 압력 저하가 주요 이상 원인.
프레스 (유사도: 0.6781) - 가열된 소재를 금형에 눌러 성형하는 설비. 유압 이상 시 성형 불량 발생.
그리고 db.index.vector.queryNodes 는 구식이라는 경고가 같이 나왔다. 나중에 마이그레이션이 필요한 레거시 부분이라고 알고 넘어가면 될 것 같다.
그런데 경고 문구를 다시 읽어보면 이상하다.
db.index.vector.queryNodes is deprecated. It is replaced by SEARCH.같은 서버가 SEARCH 는 문법 에러로 거절하면서, queryNodes 는 SEARCH 로 바꾸라고 하고 있다. 서버가 SEARCH 를 아예 모르는 거라면 저 경고가 나올 리 없다. 왜 이렇게 되는지는 아직 확인하지 못했다.
벡터로 찾고, 그래프로 넓히기
여기까지는 Chroma 로 했던 거랑 똑같다. 이번에는 벡터 검색에 그래프 관계를 붙여봤다.
search_equipment.py 에 함수를 하나 추가해서, 벡터로 비슷한 설비를 찾고 그 설비가 촉발한 알람까지 한 번에 가져오게 했다.
CALL db.index.vector.queryNodes('equipmentEmbeddings', $k, $embedding)
        YIELD node AS equip, score
        OPTIONAL MATCH (equip)-[:TRIGGERED]->(a:Alarm)
        RETURN equip.name AS name, score,
               collect(a.message) AS related_alarms
쿼리에 못 보던 게 두 개 추가됐다.
OPTIONAL MATCH: 그냥MATCH는 매칭이 안 되면 그 행 자체가 결과에서 사라진다.OPTIONAL MATCH는 매칭이 안 돼도 결과는 넘기고, 없는 부분은null로 채운다collect(): 한 설비가 알람을 여러 개 촉발하면 결과가 여러 행으로 나올 텐데, 그걸 하나의 리스트로 묶어준다

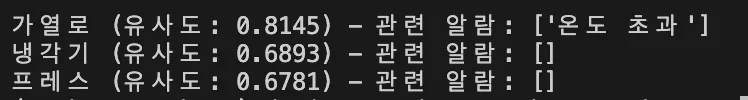
가열로 (유사도: 0.8145) - 관련 알람: ['온도 초과']
냉각기 (유사도: 0.6893) - 관련 알람: []
프레스 (유사도: 0.6781) - 관련 알람: []
관계가 설정된 노드는 알람까지 보여주고, 관계가 비어 있다고 행까지 생략하지는 않는다.
냉각기와 프레스가 [null] 이 아니라 [] 로 나온 것도 눈여겨볼 만하다. OPTIONAL MATCH 가 a 를 null 로 채우지만, collect() 는 null 을 빼고 모으기 때문에 빈 리스트가 된다.
벡터 검색만 했으면 가열로가 관련 있어 보인다는 것까지만 알려줄 수 있었다. 그래프 관계까지 들여다보니까 어떤 알람까지 일으켰는지를 한 번에 가져와서 LLM 에게 넘길 수 있게 됐다. 지난 글에서 남긴 “왜 한 DB 에 넣는가” 의 답이 이거였다.
더 공부해볼 것
SEARCH는 거절하면서SEARCH로 바꾸라는 경고는 왜 나오는가 — Cypher 25 라는 이름이 붙은 걸 보면 Cypher 에 언어 버전이 있는 것 같다. 쿼리마다 버전을 고를 수 있는지, 인스턴스 기본값이 무엇인지 확인해봐야 한다 → Neo4j: Vector indexes- Aura 의 사용자명이 왜 인스턴스 ID 인가 — 이름을 넣었다가 접근 거부를 당했다. 인스턴스 이름과 ID 가 각각 어디에 쓰이는지 정리해두고 싶다
- 임베딩 모델을 바꾸면 인덱스는 어떻게 되는가 — 인덱스를 만들 때 차원을 1536 으로 박았다. 차원이 다른 모델로 바꾸면 인덱스를 새로 만들어야 하는지 궁금하다
cosine말고 다른 유사도 함수는 언제 쓰는가 —vector.similarity_function에 다른 값도 들어가는 것 같은데, 무엇이 있고 어떤 기준으로 고르는지- 유사도 점수를 어디서 끊어야 하는가 — 가열로는 0.8145 였지만 관련 없어 보이는 냉각기 · 프레스도 0.68 대로 같이 나왔다.
k개를 무조건 채워 돌려주는 거라면 기준선이 필요할 것 같다. 예전에 recall@k 를 재본 글과 이어서 보면 좋겠다